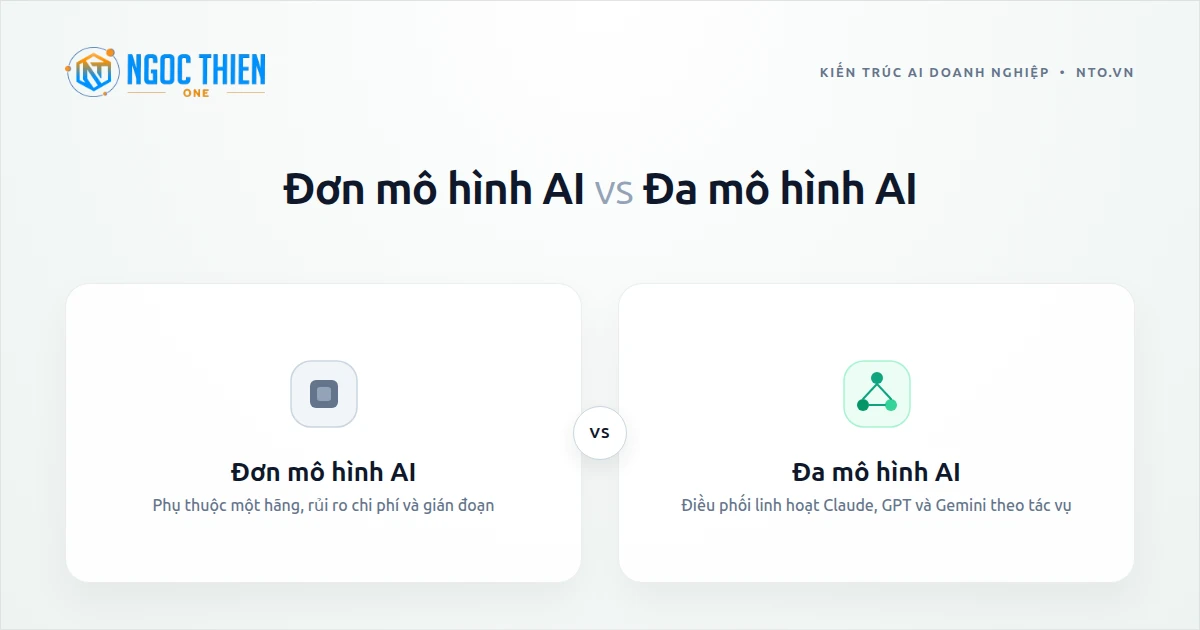
Kiến trúc đa mô hình AI cho phép doanh nghiệp phân luồng động từng truy vấn qua một cổng điều phối thống nhất thay vì phụ thuộc cứng vào một nhà cung cấp duy nhất, qua đó loại bỏ điểm nghẽn ngừng dịch vụ đơn điểm và tối ưu chi phí token trên từng tác vụ (cập nhật 18/11/2026).
Khi tốc độ cập nhật của các họ mô hình như Claude, GPT, Gemini hay Grok thay đổi liên tục theo từng quý, việc viết mã ứng dụng gắn chết vào cấu trúc API của một hãng dễ đẩy tổ chức vào thế bị động cả về kỹ thuật lẫn đàm phán chi phí.
Chuyển sang hạ tầng multi-model thông qua Azure Foundry, AWS Bedrock hoặc Google Vertex AI đang trở thành tiêu chuẩn thiết kế cốt lõi cho hệ thống AI doanh nghiệp.
Điểm mấu chốt về kiến trúc đa mô hình AI (cập nhật 18/11/2026):
- Tránh lệ thuộc nhà cung cấp: Tách lớp ứng dụng khỏi API cụ thể giúp hoán đổi mô hình mới chỉ bằng thay đổi cấu hình định tuyến.
- Tối ưu chi phí token doanh nghiệp: Phân tầng truy vấn đơn giản cho mô hình gọn nhẹ, giữ mô hình suy luận sâu cho lập trình, pháp chế và phân tích phức tạp.
- Ba nền tảng đám mây chủ lực: Microsoft Azure AI Foundry (nổi bật với Model Router), Amazon Bedrock (Converse API và danh mục rộng) và Google Cloud Vertex AI (Model Garden gắn chặt dữ liệu BigQuery).
- Quản trị tập trung: Kiểm soát danh tính, giới hạn ngân sách và dữ liệu không dùng để huấn luyện trên một lớp cổng kiểm soát thống nhất.
Vì sao doanh nghiệp cần giảm rủi ro vendor lock-in ngay từ lớp API?
Thực tế triển khai cho thấy giảm rủi ro vendor lock-in không phải câu chuyện lý thuyết xa vời mà là bài toán sống còn ngay khi ứng dụng AI vượt khỏi giai đoạn thử nghiệm vài chục người dùng.
Nếu toàn bộ quy trình chăm sóc khách hàng, phân tích hợp đồng và hỗ trợ lập trình đều gọi thẳng một điểm cuối duy nhất, doanh nghiệp lập tức đối mặt ba rủi ro: chạm trần rate limit vào giờ cao điểm, biến động đơn giá hoặc chính sách lưu trữ dữ liệu, và bỏ lỡ bước nhảy hiệu năng của các mô hình cạnh tranh mới.
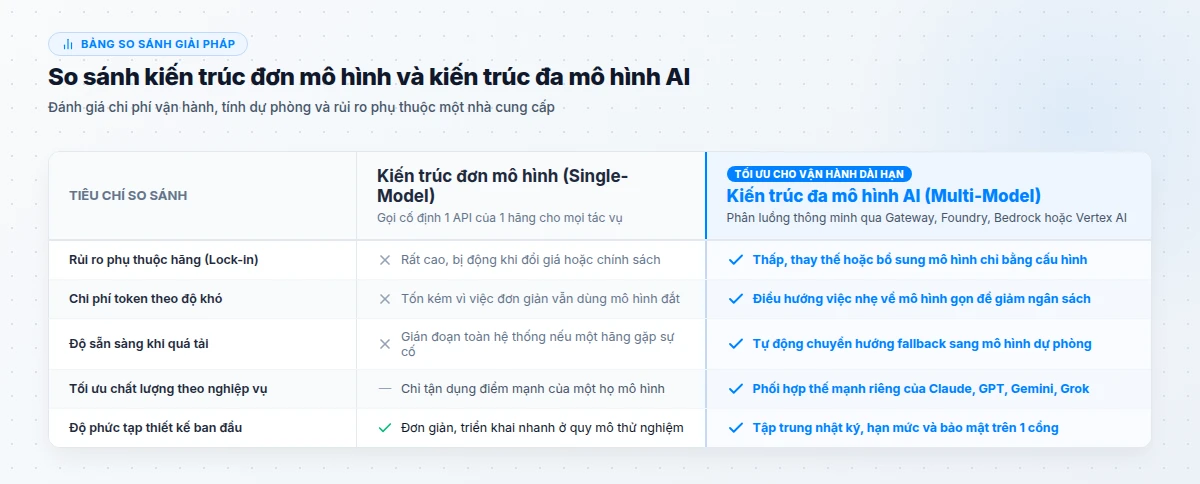
Bên cạnh đó, không có một mô hình nào giữ vị trí vượt trội tuyệt đối ở mọi tiêu chí từ tốc độ phản hồi, độ dài cửa sổ ngữ cảnh, chất lượng tiếng Việt cho tới lập trình phức tạp.
Thiết kế hạ tầng mở ngay từ đầu giúp đội ngũ kỹ thuật linh hoạt kết hợp sức mạnh của từng hãng mà không phải viết lại giao diện người dùng hay quy trình nghiệp vụ, đồng bộ với lộ trình 4 bước triển khai AI Transformation.
Chiến lược multi-model routing giữa Claude, GPT, Gemini và Grok
Áp dụng chiến lược multi-model routing hiệu quả nghĩa là hệ thống tự động đánh giá độ phức tạp, độ dài ngữ cảnh và yêu cầu tuân thủ của từng câu lệnh trước khi quyết định gửi tới mô hình nào.
Phân luồng theo độ phức tạp
Đúng mô hình cho đúng việc
Các tác vụ phân loại email, tóm tắt ngắn dùng mô hình nhẹ chi phí thấp; bài toán suy luận kiến trúc, rà soát hợp đồng chuyển sang mô hình chủ lực.
Chuyển hướng dự phòng tức thì
Cơ chế Auto-Fallback đa vùng
Khi một đầu API trả mã lỗi quá tải hoặc tăng độ trễ bất thường, bộ định tuyến lập tức đẩy truy vấn sang mô hình tương đương ở cụm dự phòng.
Chuẩn hóa qua lớp Gateway
Đồng nhất định dạng gọi hàm
Kết hợp giao thức kết nối dữ liệu chuẩn giúp giữ nguyên bộ công cụ tra cứu nội bộ dù bên dưới thay đổi giữa Claude, GPT hay Gemini.
Phân công vai trò thực tế theo thế mạnh từng họ mô hình
Trong nhiều kiến trúc thực chiến, họ mô hình Claude thường được ưu tiên cho viết lách tự nhiên, lập trình có cấu trúc và phân tích tài liệu pháp lý dài cần độ chính xác ngữ nghĩa cao.
Các dòng GPT phù hợp với hệ thống gắn chặt hệ sinh thái doanh nghiệp rộng hoặc chuỗi gọi công cụ đa bước ổn định; trong khi dòng Gemini phát huy lợi thế rõ rệt khi cần nạp kho tài liệu, video, mã nguồn rất lớn vào cửa sổ ngữ cảnh rộng, còn Grok bổ trợ cho các luồng tra cứu thông tin thời gian thực.
Để thống nhất cách mô hình tương tác với kho dữ liệu công ty mà không viết lại trình kết nối riêng lẻ cho từng hãng, đội ngũ kỹ thuật nên kết hợp chuẩn mở tại bài giao thức Model Context Protocol kết nối dữ liệu AI.
Đối chiếu 3 nền tảng triển khai: Azure Foundry, AWS Bedrock và Vertex AI
Thay vì tự duy trì hàng chục hợp đồng API rời rạc và tự xử lý bảo mật từng nơi, phần lớn doanh nghiệp lựa chọn triển khai qua một trong ba nền tảng đám mây lớn đã tích hợp sẵn danh mục đa mô hình.
| Tiêu chí so sánh | Microsoft Azure AI Foundry | Amazon Bedrock | Google Cloud Vertex AI |
|---|---|---|---|
| Danh mục mô hình hỗ trợ | OpenAI GPT, Anthropic Claude, Grok, DeepSeek, Llama, Mistral | Anthropic Claude, Amazon Nova, Meta Llama, Mistral, OpenAI | Google Gemini (độc quyền hãng), Claude và kho Model Garden |
| Cơ chế định tuyến gốc | Model Router tự đánh giá độ khó, độ trễ và chi phí theo thời gian thực | Converse API chuẩn hóa mã gọi để đổi mô hình nhanh qua tham số | Vertex AI Agent Builder kết hợp cổng điều phối tùy chỉnh |
| Quản trị danh tính & bảo mật | Microsoft Entra ID, Azure AI Search, Microsoft Purview | AWS IAM, VPC riêng, CloudTrail và Bedrock Guardrails | GCP IAM, VPC Service Controls và phân quyền BigQuery |
| Thế mạnh hạ tầng phù hợp | Doanh nghiệp dùng sâu Microsoft 365, Teams và Active Directory | Đội ngũ kỹ thuật vận hành hạ tầng chính trên AWS | Tổ chức có dữ liệu phân tích lớn trên BigQuery và Google Cloud |
Ưu thế của mô hình triển khai qua Azure Foundry
Phương án triển khai qua Azure Foundry nổi bật nhờ tính năng Model Router gốc, cho phép hệ thống tự phân tích độ phức tạp của câu hỏi ngay lúc nhận lệnh để điều hướng về mô hình tiết kiệm nhất mà không cần lập trình viên viết lại ứng dụng.
Đồng thời, việc thừa hưởng lớp xác thực Microsoft Entra ID giúp doanh nghiệp áp dụng nguyên vẹn cấu trúc phân quyền nhân sự sẵn có vào các AI agent nội bộ.
Khi nào nên chọn AWS Bedrock hoặc Google Cloud Vertex AI?
Amazon Bedrock là lựa chọn tự nhiên khi toàn bộ dịch vụ nghiệp vụ, kho lưu trữ S3 và cơ sở dữ liệu của công ty đã nằm sẵn trên AWS, giúp dữ liệu không phải đi vòng qua mạng công cộng khi gọi Claude hoặc các mô hình mở qua Converse API.
Ngược lại, Google Cloud Vertex AI kết hợp Gemini Enterprise tỏ ra vượt trội với những bài toán phân tích dữ liệu quy mô lớn gắn trực tiếp vào BigQuery và hệ sinh thái Google Workspace.
Bài toán tối ưu chi phí token doanh nghiệp và quản trị ngân sách
Một hệ thống chạy mượt về mặt kỹ thuật nhưng thiếu kiểm soát định mức rất dễ gây đội ngân sách đột biến khi nhân rộng cho hàng trăm nhân sự; vì vậy tối ưu chi phí token doanh nghiệp phải được thiết kế thành quy tắc cứng ở lớp cổng điều phối.
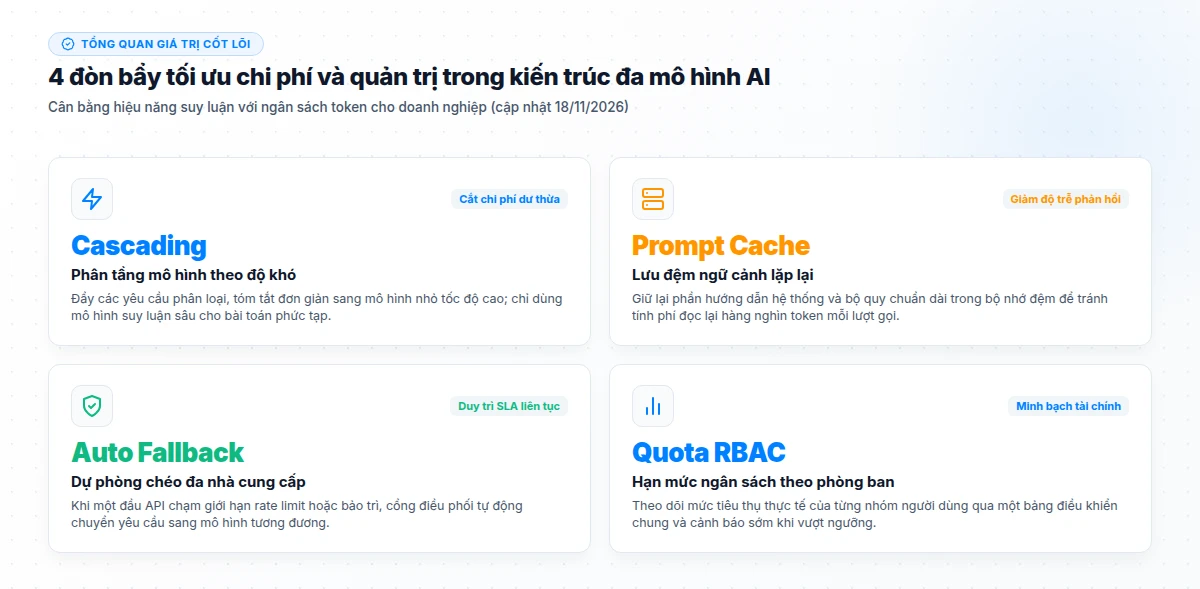
4 đòn bẩy kỹ thuật giúp giảm lãng phí ngân sách suy luận
Đầu tiên, áp dụng định tuyến phân tầng (model cascading) để chỉ những yêu cầu khó mới chạm tới mô hình đắt tiền, giúp tiết kiệm phần lớn chi phí cho nhóm tác vụ tóm tắt, dịch thuật hoặc gắn thẻ thông thường.
Thứ hai, bật cơ chế lưu đệm ngữ cảnh (prompt caching) cho các tệp quy trình nội bộ dài cố định và gom các việc không cần phản hồi tức thì vào luồng xử lý bất đồng bộ theo lô.
Thứ ba, thiết lập bộ tiêu chuẩn đánh giá định kỳ (evaluation benchmark) gồm 50 đến 100 mẫu truy vấn nghiệp vụ thật mỗi khi đổi trọng số định tuyến nhằm bảo đảm việc hạ chi phí không làm sụt giảm độ chính xác chuyên môn.
Thứ tư, áp đặt hạn mức quota theo từng phòng ban gắn với nhật ký sử dụng minh bạch, kết hợp thêm cập nhật chuyên sâu tại chuyên mục giải pháp công nghệ AI tại NTO.
Để quy hoạch đồng bộ cả gói bản quyền phần mềm nền tảng lẫn hạ tầng AI chính hãng có đầy đủ hợp đồng và hóa đơn VAT hợp lệ tại Việt Nam, doanh nghiệp có thể làm việc với NTO — đơn vị tư vấn & cung cấp bản quyền phần mềm & giải pháp AI chính hãng.
Câu hỏi thường gặp về kiến trúc đa mô hình AI
Phần hỏi đáp dưới đây giải thích các điểm vướng mắc thường gặp khi kiến trúc sư hệ thống và bộ phận tài chính cùng thẩm định dự án AI.
Có, nhưng nên bắt đầu đơn giản bằng một cổng API thống nhất hoặc dùng sẵn nền tảng như Azure AI Foundry, AWS Bedrock để giữ khả năng chuyển đổi mô hình khi cần mà không tăng chi phí bảo trì hạ tầng.
Độ trễ ở lớp định tuyến thường chỉ tính bằng vài chục mili-giây, trong khi việc chọn đúng mô hình nhẹ cho câu hỏi đơn giản thực tế lại giúp tốc độ trả kết quả nhanh hơn hẳn so với ép mô hình lớn xử lý mọi việc.
Nếu triển khai qua các nền tảng đám mây doanh nghiệp như Azure Foundry, AWS Bedrock hoặc Google Vertex AI, dữ liệu được bao bọc trong cùng một ranh giới mạng riêng, tuân thủ cam kết không dùng để huấn luyện mô hình công cộng.
Đội ngũ kỹ thuật nên xây dựng bộ tiêu chuẩn đánh giá tự động gồm 50 đến 100 mẫu câu hỏi nghiệp vụ thật để chấm điểm độ chính xác, độ trễ và chi phí trên mỗi lượt chạy trước khi thay đổi tỷ trọng phân luồng.
Khung quyết định lựa chọn kiến trúc theo quy mô tổ chức
Kiến trúc đa mô hình AI giúp doanh nghiệp làm chủ lộ trình công nghệ dài hạn, cân bằng giữa chất lượng suy luận của từng họ mô hình với khả năng dự phòng và kiểm soát ngân sách token.
Tổ chức quy mô nhỏ có thể xuất phát gọn nhẹ bằng một lớp trừu tượng API duy nhất hoặc gói tài khoản AI doanh nghiệp chuẩn; trong khi các doanh nghiệp từ trung bình đến lớn nên tận dụng Azure AI Foundry, AWS Bedrock hoặc Google Vertex AI tùy theo nền tảng đám mây và dữ liệu hiện có.
Quý khách cần tư vấn quy hoạch giải pháp AI, bản quyền phần mềm doanh nghiệp chính hãng hoặc báo giá kèm hợp đồng và hóa đơn VAT đầy đủ? Vui lòng liên hệ NTO qua Hotline 1900 252 388 hoặc Email cskh@ngocthien.one để được hỗ trợ chi tiết.