GPT-Synopsys đánh dấu bước ngoặt khi mô hình AI chuyên biệt của OpenAI và Synopsys cải thiện tới 14% chỉ số PPA trên khối IP GPU flagship của AMD ngày 18/11/2026. Kết quả thực nghiệm này nén khối lượng tối ưu kéo dài một năm xuống dưới năm tháng.
Không dừng ở mô phỏng lý thuyết, một số mạch thiết kế lại bằng SystemVerilog RTL đã chính thức được đưa vào bản thiết kế gửi đi sản xuất. Trên dòng chip suy luận Jalapeño, hệ thống còn giúp thu gọn khoảng 13% diện tích cell tại khối vector.
Bài phân tích dưới đây tổng hợp số liệu kỹ thuật mới nhất từ bài công bố kỹ thuật của OpenAI, cơ chế vận hành của GPT-Synopsys và phương án chuẩn bị hạ tầng API cho doanh nghiệp công nghệ tại Việt Nam.
Tóm tắt nhanh cột mốc GPT-Synopsys và AI thiết kế chip AMD (18/11/2026)
- Hiệu năng phần cứng thực: Cải thiện tới 14% chỉ số PPA (Power, Performance, Area) trên IP GPU chủ lực của AMD.
- Rút ngắn tiến độ R&D: Nén chu kỳ tối ưu hóa truyền thống từ 12 tháng xuống dưới 5 tháng với mạch SystemVerilog RTL đã tape-out.
- Thu gọn chip Jalapeño: Giảm khoảng 13% diện tích vector cell (warp engine) và 10% diện tích khối matrix unit.
- Hợp tác chiến lược EDA: Thỏa thuận OpenAI – Synopsys công bố từ 30/09/2026 tạo nền tảng mô hình chuyên sâu thao tác công cụ thiết kế vi mạch.
- Triển khai tại Việt Nam: Doanh nghiệp nghiên cứu và phần mềm có thể nạp OpenAI API qua NTO với đầy đủ hóa đơn VAT.
GPT-Synopsys và cột mốc AI tối ưu 14% PPA trên chip AMD ngày 18/11/2026
Ngày 18/11/2026, OpenAI công bố báo cáo kỹ thuật xác nhận các mô hình suy luận tiên tiến đã trực tiếp tham gia tối ưu thiết kế vi mạch cho kiến trúc GPU flagship và CPU thế hệ mới của AMD. Trong ngành bán dẫn, chỉ số PPA quyết định sức cạnh tranh thương mại của mọi bộ xử lý.
Thay vì chỉ gợi ý đoạn mã đơn lẻ, GPT-Synopsys được phát triển dựa trên liên minh chiến lược giữa OpenAI và Synopsys công bố lần đầu vào ngày 30/09/2026. Mục tiêu của chương trình này là huấn luyện mô hình hiểu sâu ngữ cảnh vật lý silicon và quy trình EDA.
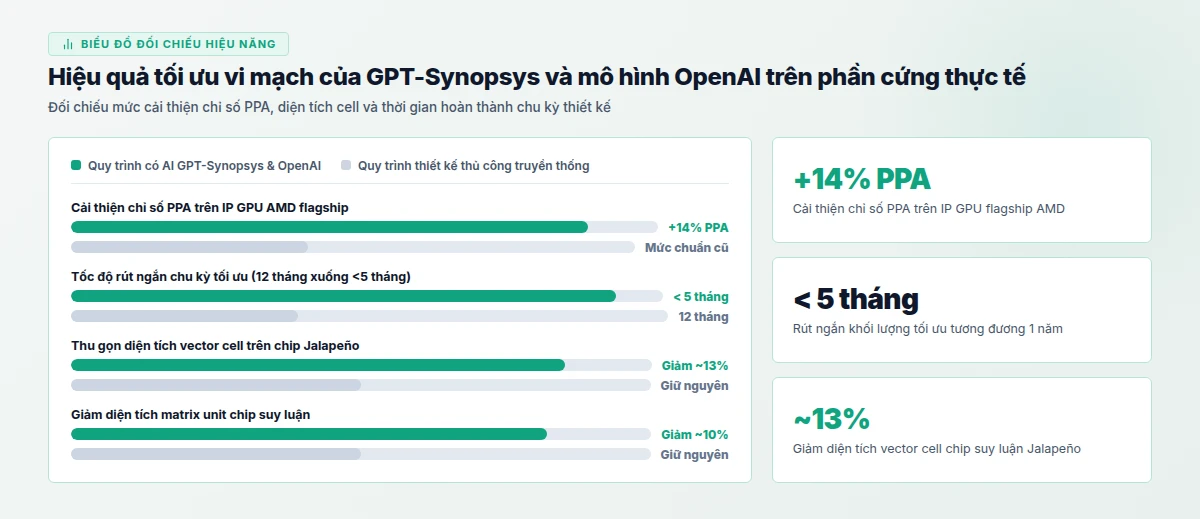
Theo dữ liệu công bố ngày 18/11/2026, đội ngũ kỹ sư đã đo được mức cải thiện lên tới 14% PPA trên nhiều khối IP GPU phức tạp của AMD. Để đạt biên độ tối ưu tương tự bằng phương pháp tinh chỉnh thủ công, một nhóm chuyên gia dày dạn thường mất trọn vẹn một năm.
Nhờ sự hỗ trợ từ hệ thống tác nhân suy luận, chu kỳ làm việc đó được rút xuống dưới năm tháng. Các phiên bản mạch SystemVerilog RTL do AI tái cấu trúc không nằm trên giấy mà đã vượt qua kiểm định để tiến tới bước tape-out sản xuất thực tế.
Cơ chế tự động hóa SystemVerilog RTL và bài toán giảm diện tích chip xử lý
Điểm nghẽn lớn nhất trong thiết kế phần cứng hiện đại là sự bùng nổ tổ hợp tham số khi tổng hợp mạch từ mã RTL sang cổng logic vật lý. GPT-Synopsys giải quyết bài toán này bằng cách vận hành như một tác nhân kỹ thuật bán dẫn có khả năng đọc hiểu báo cáo định thời.
Thử nghiệm nội bộ trên chip suy luận Jalapeño do OpenAI tự thiết kế cho thấy hiệu quả rõ rệt trong việc giảm diện tích chip xử lý. Cụ thể, mô hình đề xuất phương án tái sắp xếp logic giúp cắt giảm xấp xỉ 13% diện tích cell tại khối vector (warp engine).
Bên cạnh khối vector, thành phần matrix unit đảm nhiệm phép nhân ma trận trọng số cũng ghi nhận mức tiết kiệm khoảng 10% diện tích silicon. Khi thu nhỏ diện tích mà vẫn giữ nguyên xung nhịp, mật độ bộ nhớ đệm trên mỗi wafer tăng lên và chi phí gia công giảm xuống đáng kể.
3 điểm khác biệt của mô hình GPT-Synopsys so với AI viết code thông thường
Các mô hình lập trình phổ thông thường gặp ảo giác khi sinh mã mô tả phần cứng do thiếu hiểu biết về xung nhịp đồng hồ và trễ đường truyền. Kiến trúc chuyên biệt của GPT-Synopsys khắc phục hạn chế đó nhờ tích hợp trực tiếp vòng phản hồi từ bộ công cụ EDA.
- Thấu hiểu ngữ nghĩa SystemVerilog RTL: Mô hình phân tích cây phụ thuộc tín hiệu, tránh tạo vòng lặp tổ hợp gây lỗi tổng hợp mạch.
- Đọc trực tiếp log công cụ Synopsys: Tự động diễn giải cảnh báo vi phạm setup/hold time và đề xuất tái cấu trúc đường ống lệnh.
- Cân bằng đa mục tiêu PPA: Không hy sinh mức tiêu thụ điện năng chỉ để ép xung nhịp hoặc thu gọn diện tích mù quáng.
Bảng đối chiếu hiệu năng trước và sau khi dùng tác nhân kỹ thuật bán dẫn
Để giúp các trưởng nhóm R&D hình dung rõ giá trị đo lường được, bảng dưới đây tổng hợp các thông số đã xác nhận giữa quy trình thủ công truyền thống và quy trình tích hợp GPT-Synopsys tính đến ngày 18/11/2026.
| Tiêu chí kỹ thuật | Quy trình kỹ sư truyền thống | Tích hợp GPT-Synopsys & OpenAI |
|---|---|---|
| Chỉ số PPA trên IP GPU AMD | Mốc chuẩn tham chiếu (0%) | Cải thiện tới 14% PPA thực tế |
| Thời gian hoàn tất chu kỳ tối ưu | Khoảng 12 tháng liên tục | Rút ngắn xuống dưới 5 tháng |
| Diện tích khối vector (Jalapeño) | 100% diện tích thiết kế gốc | Giảm khoảng 13% diện tích cell |
| Diện tích khối matrix unit | 100% diện tích thiết kế gốc | Giảm khoảng 10% diện tích cell |
| Trạng thái triển khai sản xuất | Kiểm thử thủ công từng vòng | Nhiều mạch SystemVerilog RTL đã tape-out |
Những con số này cho thấy sự chuyển dịch rõ nét trong chuỗi cung ứng phần cứng toàn cầu. Theo dõi thêm các cập nhật mới nhất tại chuyên mục tin công nghệ AI giúp đội ngũ kỹ thuật tại Việt Nam kịp thời nắm bắt xu hướng công cụ AI chuyên ngành.
3 bước ứng dụng quy trình AI hỗ trợ thiết kế phần cứng và kỹ thuật tại doanh nghiệp
Dù GPT-Synopsys hướng tới môi trường thiết kế chip chuyên sâu cùng Synopsys, nguyên lý phối hợp tác nhân AI với công cụ kiểm thử tự động hoàn toàn có thể áp dụng cho doanh nghiệp kỹ thuật và phát triển phần mềm nhúng ngay hôm nay.
1. Chuẩn hóa đặc tả và bộ kiểm thử
Xây dựng bộ testbench chuẩn và ngưỡng nghiệm thu rõ ràng trước khi giao tác vụ sinh mã cho AI. Tác nhân chỉ phát huy hiệu quả khi có tiêu chí đo lường khách quan.
2. Kết nối vòng lặp phản hồi tự động
Sử dụng OpenAI API kết nối trình biên dịch hoặc trình kiểm tra tĩnh để mô hình tự sửa lỗi cú pháp và tối ưu hiệu suất qua từng vòng lặp khép kín.
3. Duy trì kiểm soát bởi kỹ sư trưởng
Mọi bản sửa đổi kiến trúc lõi hoặc cấu hình phần cứng đều phải qua bước duyệt thủ công (Human-in-the-loop) trước khi phát hành chính thức.
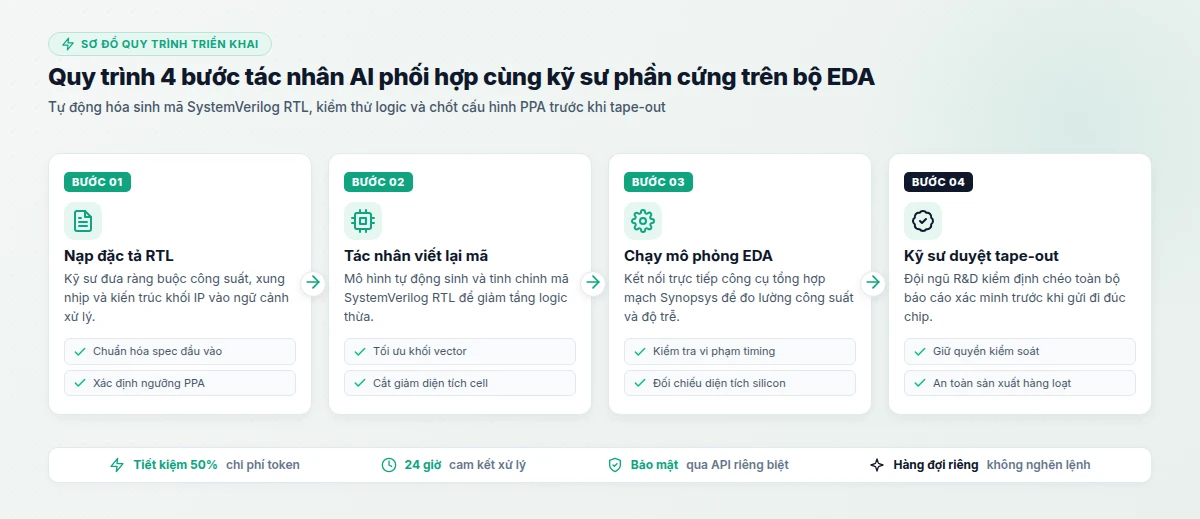
Cách tiếp cận chia lớp này giúp tránh rủi ro phụ thuộc mù quáng vào AI trong các hệ thống đòi hỏi độ tin cậy cao. Doanh nghiệp có thể bắt đầu từ những phân hệ ít rủi ro như viết kịch bản kiểm thử tự động hoặc phân tích nhật ký mô phỏng trước khi mở rộng sang tối ưu kiến trúc.
Chi phí nạp OpenAI API doanh nghiệp có hóa đơn VAT tại NTO ngày 19/11/2026
Để xây dựng các tác nhân kỹ thuật bán dẫn, công cụ phân tích mã RTL hoặc hệ thống tự động hóa nội bộ trên nền tảng OpenAI, doanh nghiệp cần nguồn credit API ổn định và chứng từ kế toán hợp lệ. Việc dùng thẻ tín dụng cá nhân thanh toán trực tiếp thường gặp rào cản hạch toán thuế.
Là đơn vị tư vấn và cung cấp giải pháp AI bản quyền chính hãng tại Việt Nam, Ngọc Thiên One (NTO) hỗ trợ dịch vụ nạp OpenAI API doanh nghiệp trả trước theo ba định mức minh bạch. Mức giá dưới đây đã bao gồm 10% VAT và cập nhật đến ngày 19/11/2026:
- Gói Starter 300: Giá 12.023.000đ (đã gồm 10% VAT), phù hợp nhóm R&D thử nghiệm tác nhân suy luận và công cụ kiểm thử tự động.
- Gói Growth 500: Giá 20.024.000đ (đã gồm 10% VAT), đáp ứng đội ngũ phát triển phần mềm và quy trình xử lý tài liệu kỹ thuật quy mô vừa.
- Gói Enterprise 1000: Giá 40.084.000đ (đã gồm 10% VAT), tối ưu cho tổ chức vận hành nhiều pipeline AI liên tục với nhu cầu hạn mức cao.
Quý khách có thể tham khảo chi tiết chính sách cấp phát, hợp đồng và thời gian kích hoạt tại trang bảng giá nạp OpenAI API có hóa đơn VAT. Dữ liệu gửi qua API doanh nghiệp được tách biệt theo chính sách bảo mật thương mại của hãng, không dùng để huấn luyện mô hình công cộng.
Câu hỏi thường gặp về mô hình GPT-Synopsys và OpenAI API
Phần giải đáp dưới đây tổng hợp những thắc mắc phổ biến của các giám đốc công nghệ và trưởng phòng R&D khi theo dõi thông tin về GPT-Synopsys cũng như khả năng tiếp cận hạ tầng OpenAI API.
Không. Theo công bố ngày 18/11/2026, GPT-Synopsys đóng vai trò tác nhân tăng tốc tìm kiếm phương án tối ưu PPA và viết lại mã SystemVerilog RTL, nhưng kỹ sư phần cứng vẫn chịu trách nhiệm xác minh cuối cùng trước khi tape-out.
Hiện tại GPT-Synopsys là mô hình chuyên sâu phát triển từ hợp tác giữa OpenAI và Synopsys gắn liền với hệ sinh thái công cụ EDA của Synopsys, không mở đại trà trên giao diện ChatGPT phổ thông.
Mức cải thiện tới 14% chỉ số PPA (Power, Performance, Area) được ghi nhận trực tiếp trên các khối IP GPU flagship của AMD, giúp nén khối lượng việc một năm xuống dưới năm tháng và đã có mạch đi tới bước sản xuất.
Khi nạp OpenAI API qua NTO (Starter 300 giá 12.023.000đ, Growth 500 giá 20.024.000đ, Enterprise 1000 giá 40.084.000đ cập nhật 19/11/2026), quý khách nhận đầy đủ hợp đồng và hóa đơn VAT 10% hợp lệ.
Theo điều khoản API thương mại của OpenAI, dữ liệu đầu vào và đầu ra qua API không được sử dụng để huấn luyện các mô hình nền tảng mặc định, đảm bảo an toàn tài sản trí tuệ cho doanh nghiệp.
Kết luận và định hướng triển khai
Sự xuất hiện của GPT-Synopsys cùng thành tích tăng 14% PPA cho chip AMD và thu gọn 13% diện tích cell chip Jalapeño chứng minh AI đã bước vào giai đoạn trực tiếp kiến tạo phần cứng thực thụ. Doanh nghiệp biết kết hợp tác nhân suy luận với bộ công cụ kiểm thử chuyên ngành sẽ tạo ra lợi thế rút ngắn thời gian ra mắt sản phẩm rõ rệt.
Đối với các tổ chức chuyên thiết kế vi mạch dùng hệ sinh thái Synopsys, việc theo dõi lộ trình phát hành từ hãng là ưu tiên hàng đầu. Trong khi đó, các nhóm phát triển phần mềm nhúng và R&D có thể bắt đầu ngay bằng việc nạp OpenAI API định mức Starter 300 hoặc Growth 500 để xây dựng quy trình tự động hóa nội bộ.
Quý khách cần tư vấn gói nạp OpenAI API doanh nghiệp (Starter 300, Growth 500, Enterprise 1000) kèm hợp đồng và hóa đơn VAT 10% minh bạch, vui lòng liên hệ Ngọc Thiên One (NTO) qua hotline 1900 252 388 hoặc email cskh@ngocthien.one để được kỹ sư tư vấn cấu hình phù hợp.